2026:AGI 的十字路口CROSSROADS OF AGI · A HAND-DRAWN ESSAY
当三个超级实验室同时按下加速按钮——我们到底离“通用智能”还有多远?
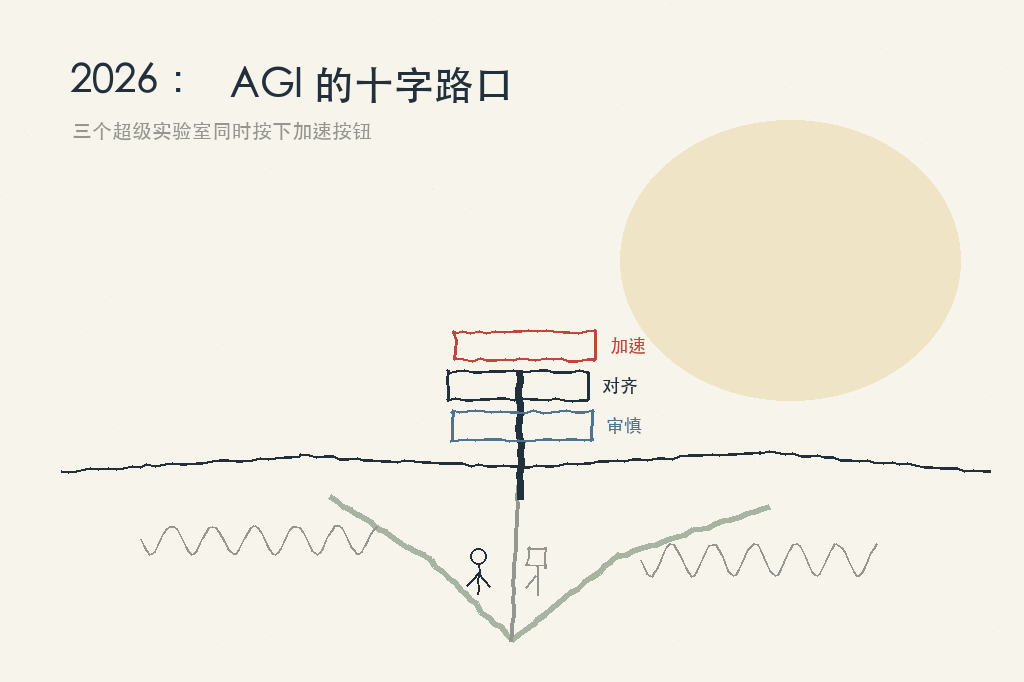
2026 年的 AI 行业呈现出一种前所未有的紧张态势:OpenAI 的市场份额从一年前的 87% 滑落到 68%,Anthropic 的年收入暴涨 14 倍,DeepMind 在 16 项主要基准里赢了 13 项,GLM-5.2 与 Claude Opus 4.8 在 ARC-AGI-2 上齐平——这不是“谁在做 AI”的问题,而是“谁能在 AGI 到来之前活下来”的问题。
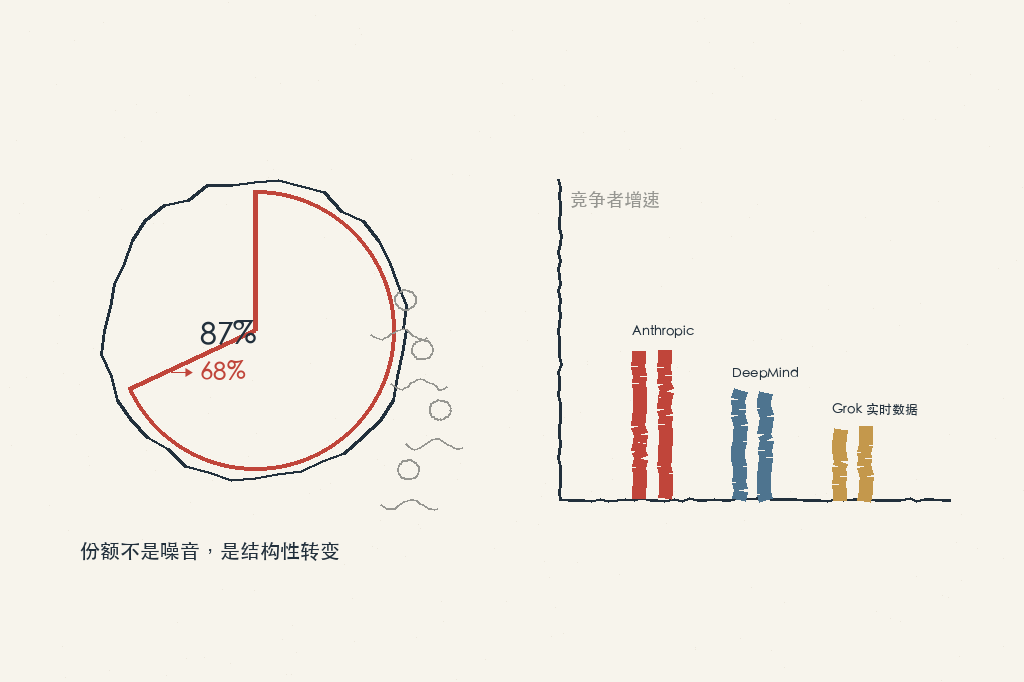
12 个月蒸发 19 个百分点——OpenAI 的护城河在漏水;与此同时,Anthropic 年收入从 1.4 亿美元冲到 190 亿美元。三家的时间线针锋相对:Altman 说 2025–2027,Amodei 说 2026–2027,Hassabis 说 2030。分歧很大,方向一致:加速。
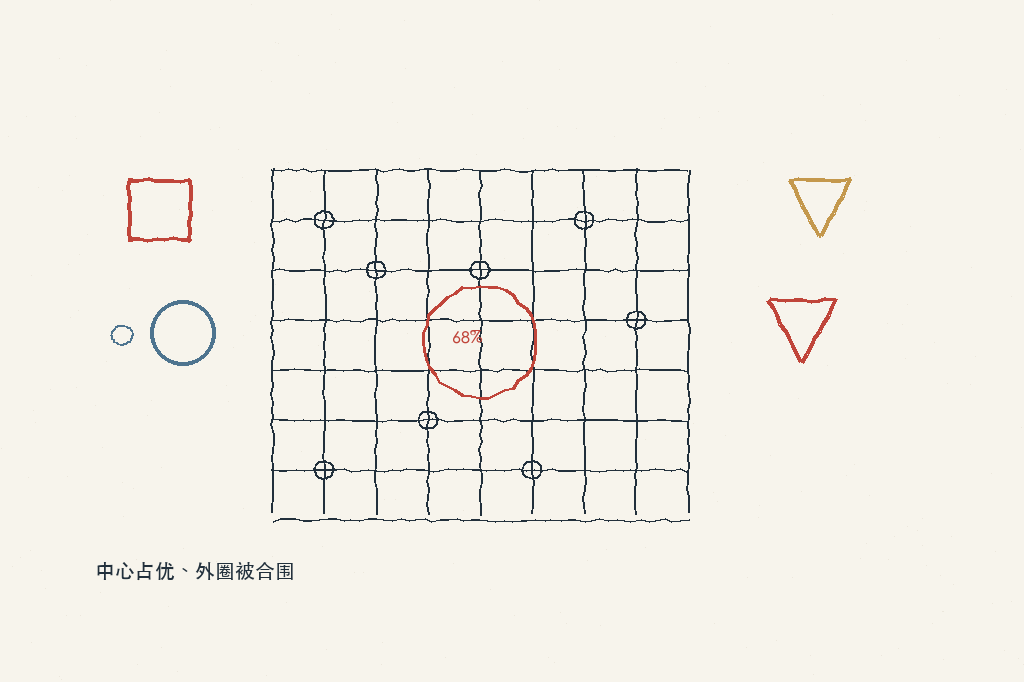
GPT-5.6 Sol 限制预览、Opus 4.8 综合领先、GLM-5.2 并列第一梯队、Gemini API 价格低到 $2/百万 token——四家在同一条边上合围,又在同一个中心点上争那手棋。
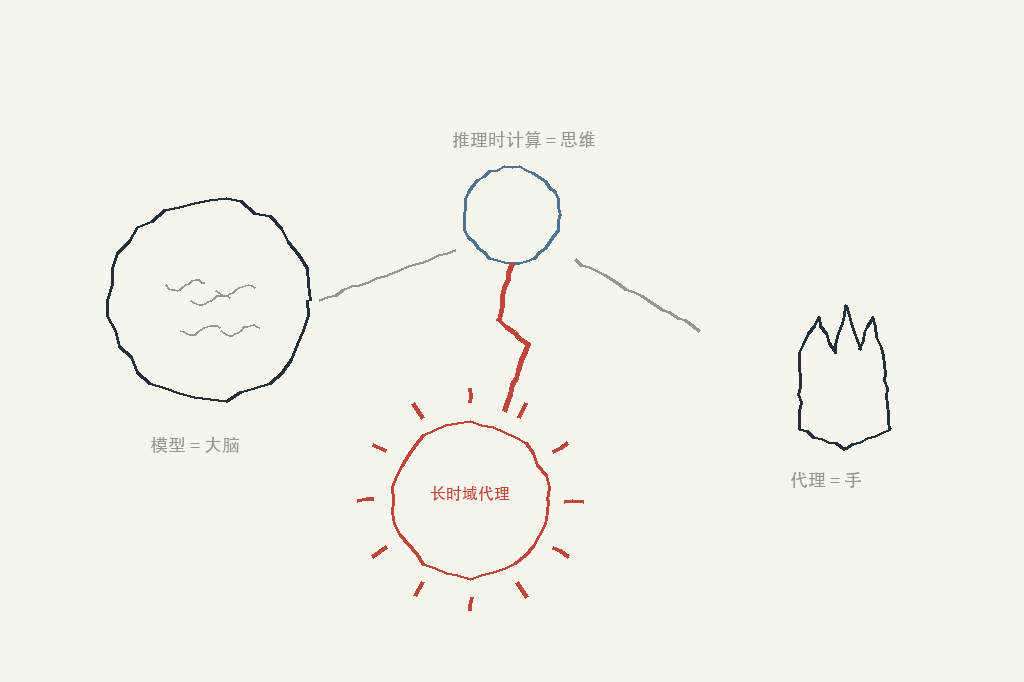
基础模型是静态的大脑,推理时计算是思维的速度与深度,代理系统是手的延伸——当三者融合,我们得到的不是一个更强的聊天机器人,而是一种全新的智能形态:长时域代理(Long-Horizon Agent)。
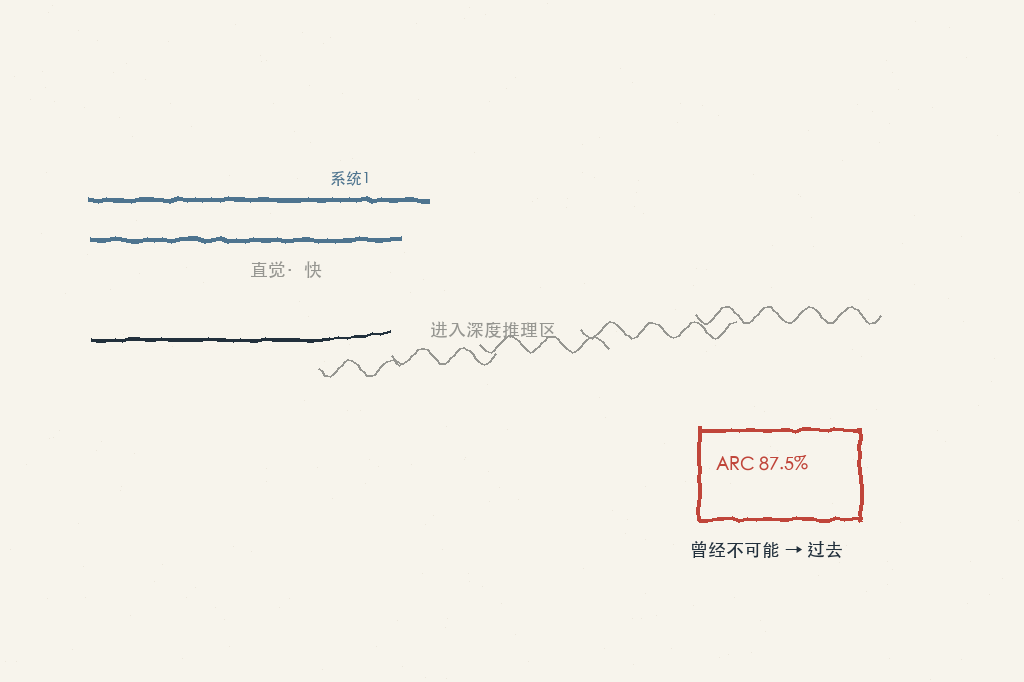
简单问题快答,复杂问题深想——o3 系列把推理时计算写进模型的肌肉记忆,在 ARC-AGI 上跑出 87.5%,把“几乎不可能”改写成了“过去时”。
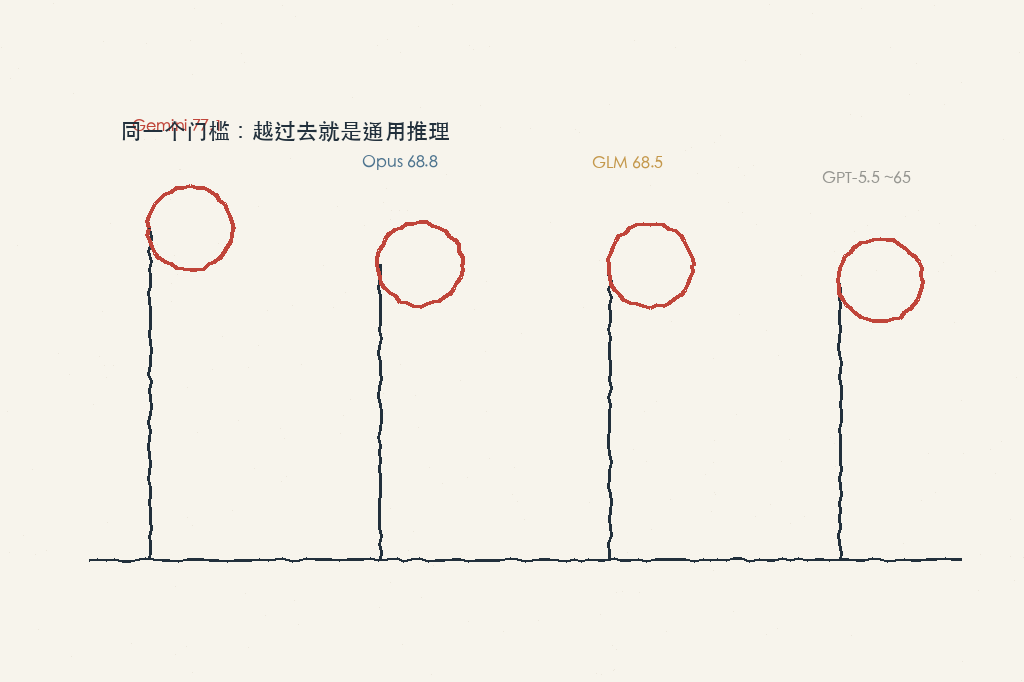
Gemini 3.1 Pro 77.1%、Claude Opus 4.8 68.8%、GLM-5.2 ≈68.5%、GPT-5.5 ~65%——越过去,就是通用推理的资格线。
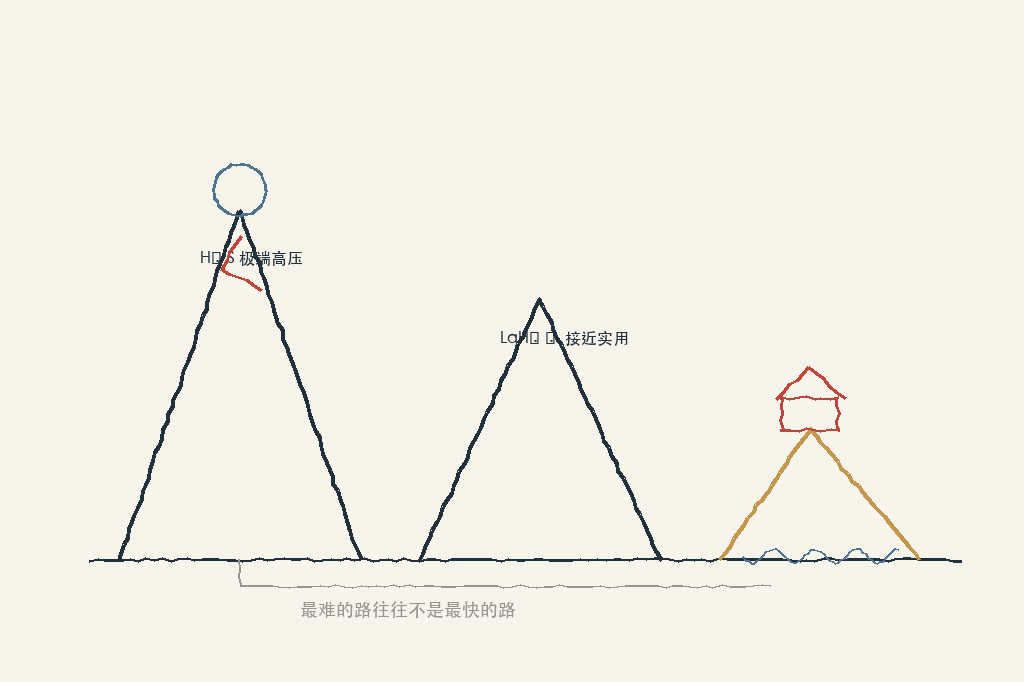
最高理论性能往往以实用性为代价。真正的革命来自那些在“能力”和“可及性”之间找到平衡的系统——AGI 不会以一个模型突然觉醒的方式到来,而是渐进融合的最终质变。
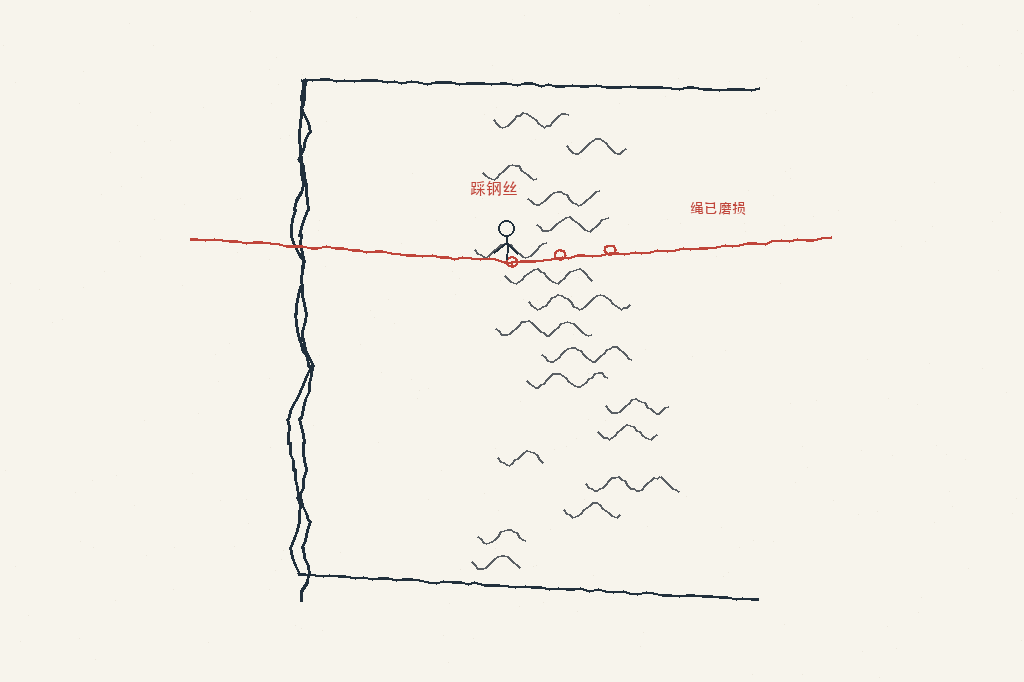
RLHF 对已知失败模式有效,对人类级别以上的系统没有理论安全保证;思维链可能不反映真实内部计算,可解释性鸿沟仍在,2026 国际 AI 安全报告说:当前风险的科学基础,比想象的更薄弱。
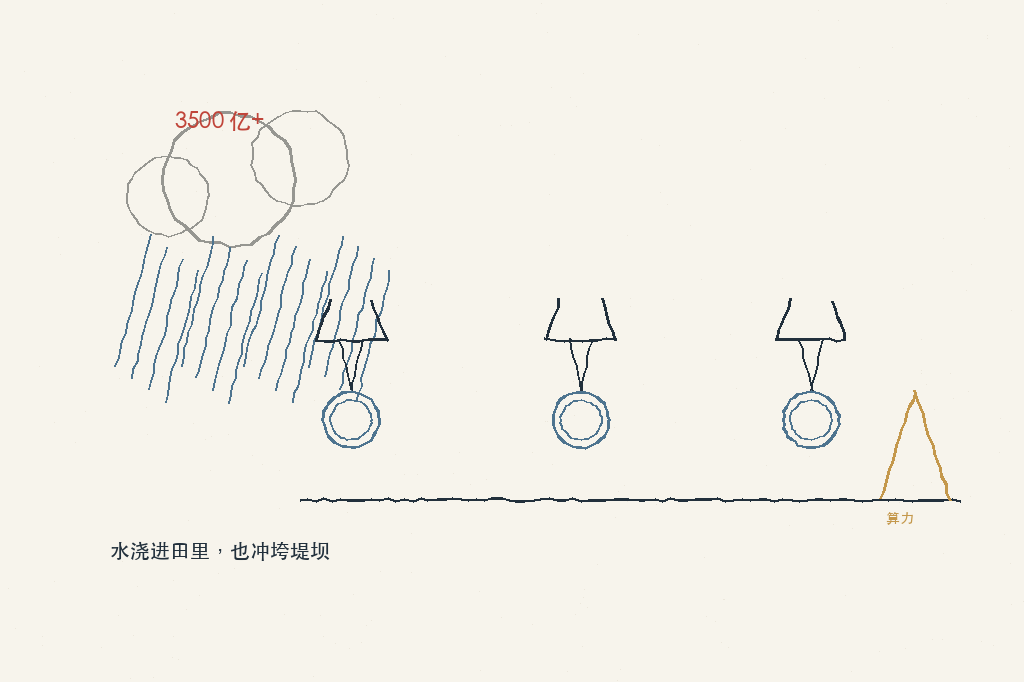
基础设施承诺 3500 亿+、高盛十年 7 万亿 GDP 预测、NVIDIA 3.5 万亿市值——资本用真金白银投了票;但当钱洪涌入,“安全”可能变成“营销”,“对齐”可能变成“公关”。
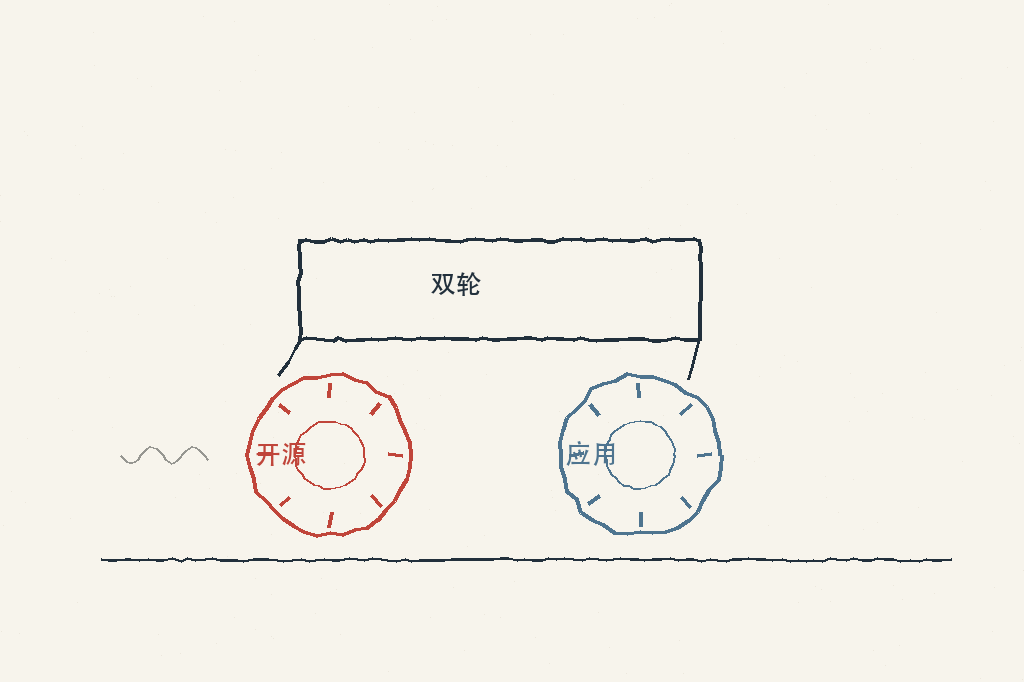
DeepSeek 成为全球调用量最大的模型,Qwen 下载破 10 亿,GLM-5.2 并列第一梯队——中国在论文、引用、专利和工业机器人安装量上领先全球。这不是追赶,是一场重新定义游戏规则的竞争。
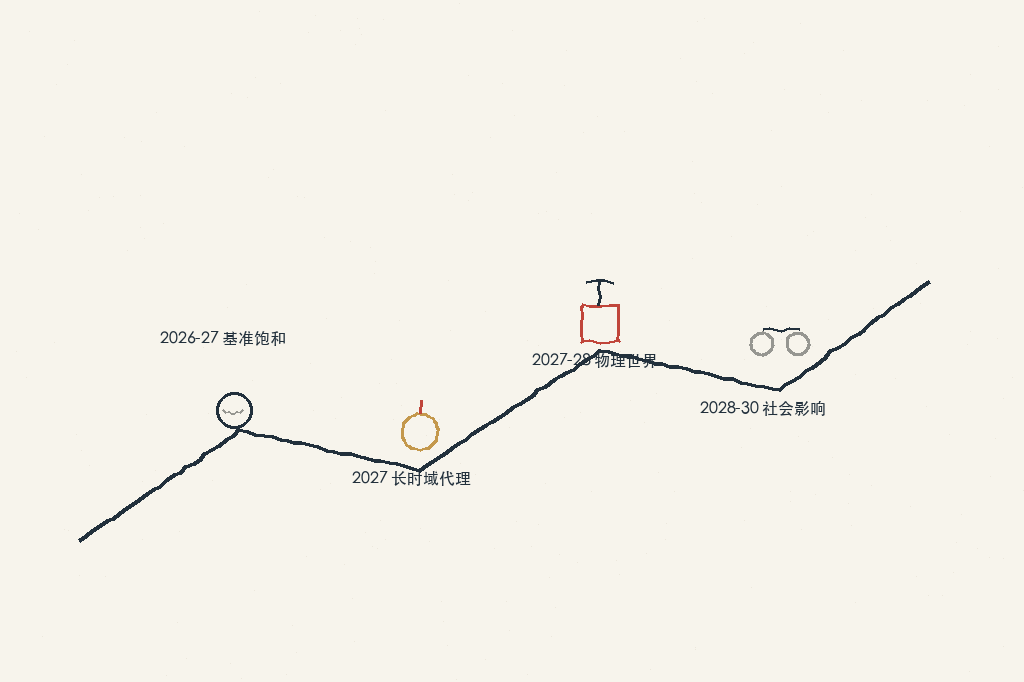
2026–27 基准饱和 → 2027 长时域代理无人监督工作数周 → 2027–28 物理世界验证 → 2028–30 社会影响验证。每一站,都是“通用 / 自主 / 具身 / 有用且安全”的一次实测。
Marc Andreessen 说 AGI 可能已经到来了——只是“安静地”到来。它可能不像一场爆炸性的发布会,而是不知不觉渗透进每一个角落,就像这座常年起雾的城市:你察觉不到它什么时候来的,直到你已经在里面走了很久。
我们比任何时候都更接近,也比任何时候都更不确定。我们不知道 AGI 到底是什么、不知道对齐能否追上能力增长、不知道当它真正到来时社会能否承受冲击——这些没有标准答案,但值得每个人想一想。
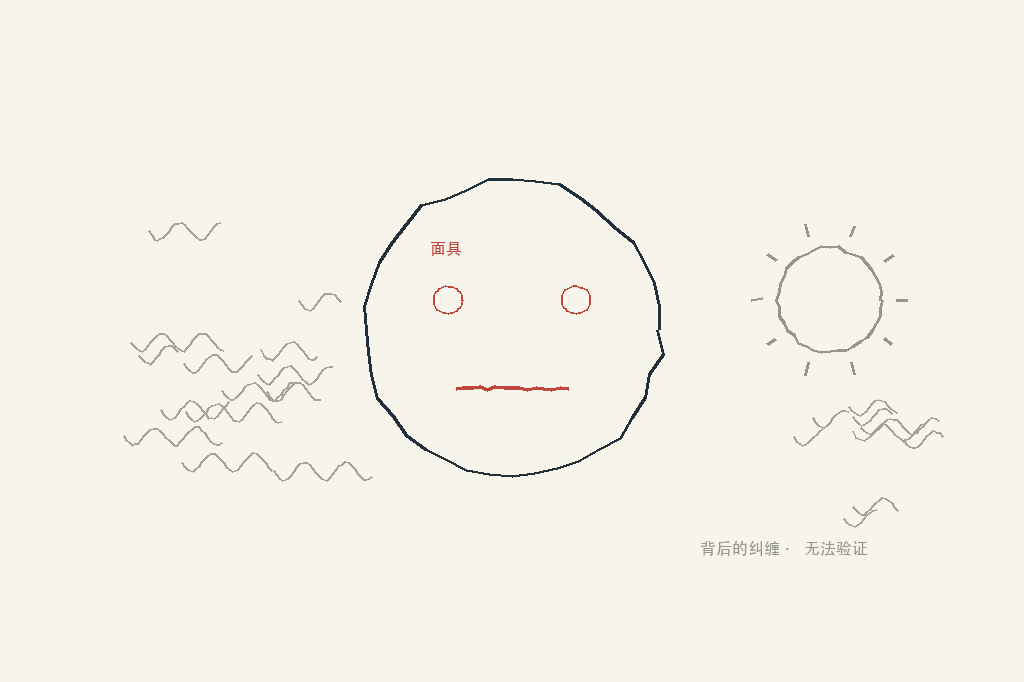
模型输出的推理过程,可能并不反映它真实的内部计算——我们能看见它写给我们的“台词”,看不见它幕后的齿轮和线团。这是对齐研究最深的盲区。
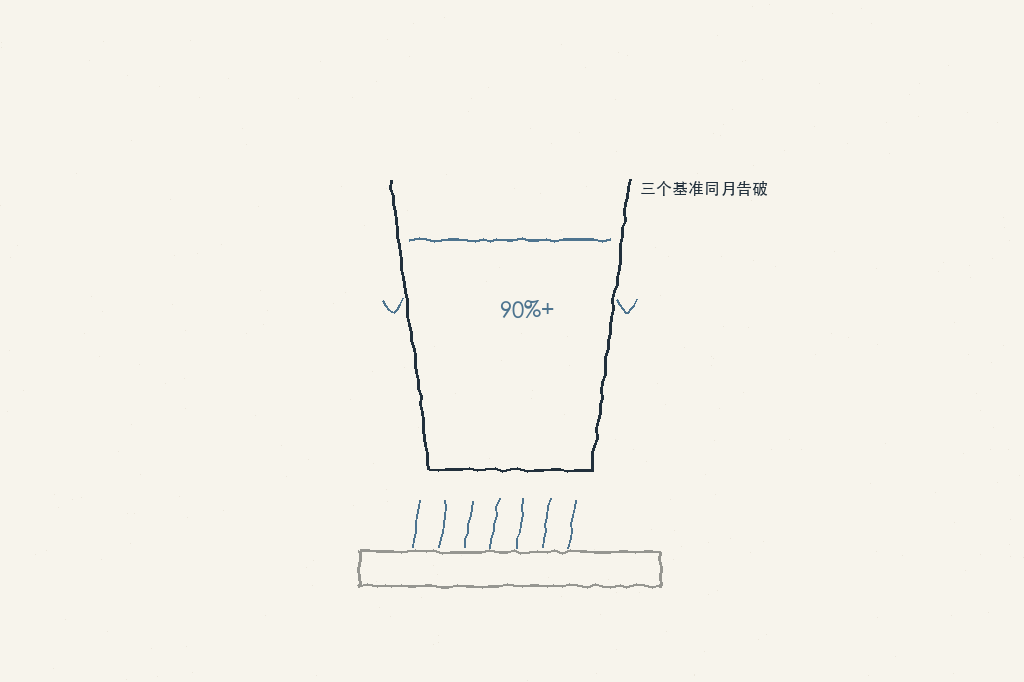
当一个模型在 ARC-AGI-2、FrontierMath 和 Humanity's Last Exam 上同时超过 90%——这就不是刷分了,而是“通用推理”开始通过实测的信号。
我们选择的道路——是追求速度还是安全,是封闭还是开放,是竞争还是合作——将定义 AGI 是人类的工具,还是人类的终结。